01 / ЗАДАЧА
Что требовалось изменить
Поиск ответа в объёмной технической документации занимает время, а обычный чат с LLM без привязки к документам может дать правдоподобный, но неверный ответ — модель отвечает по своим догадкам, а не по факту.
AI-помощник по технической документации: поиск по смыслу, ответы на основе источников, локальный бесплатный inference.
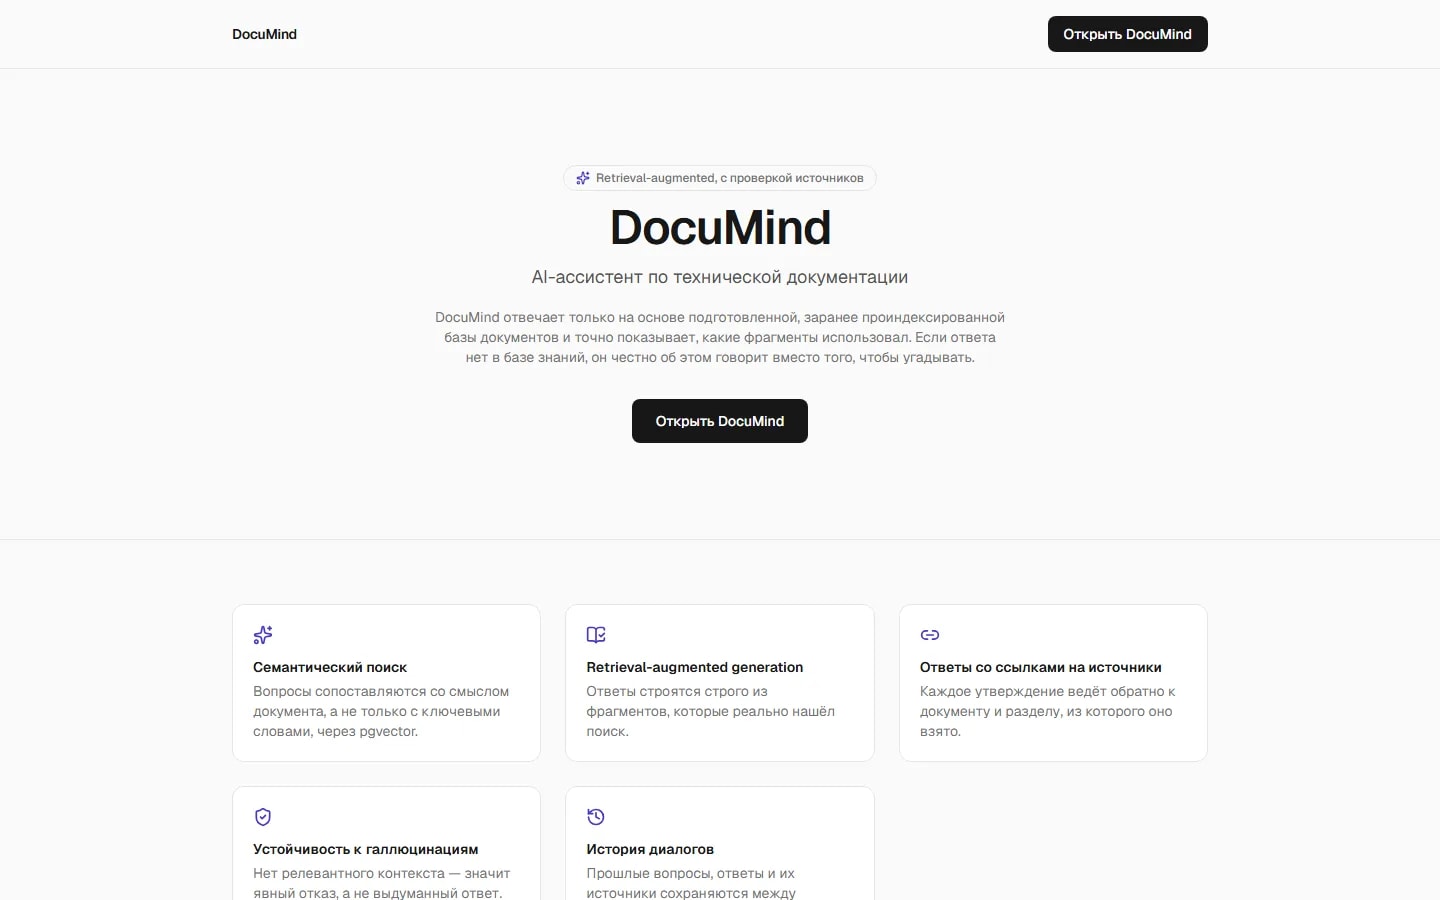
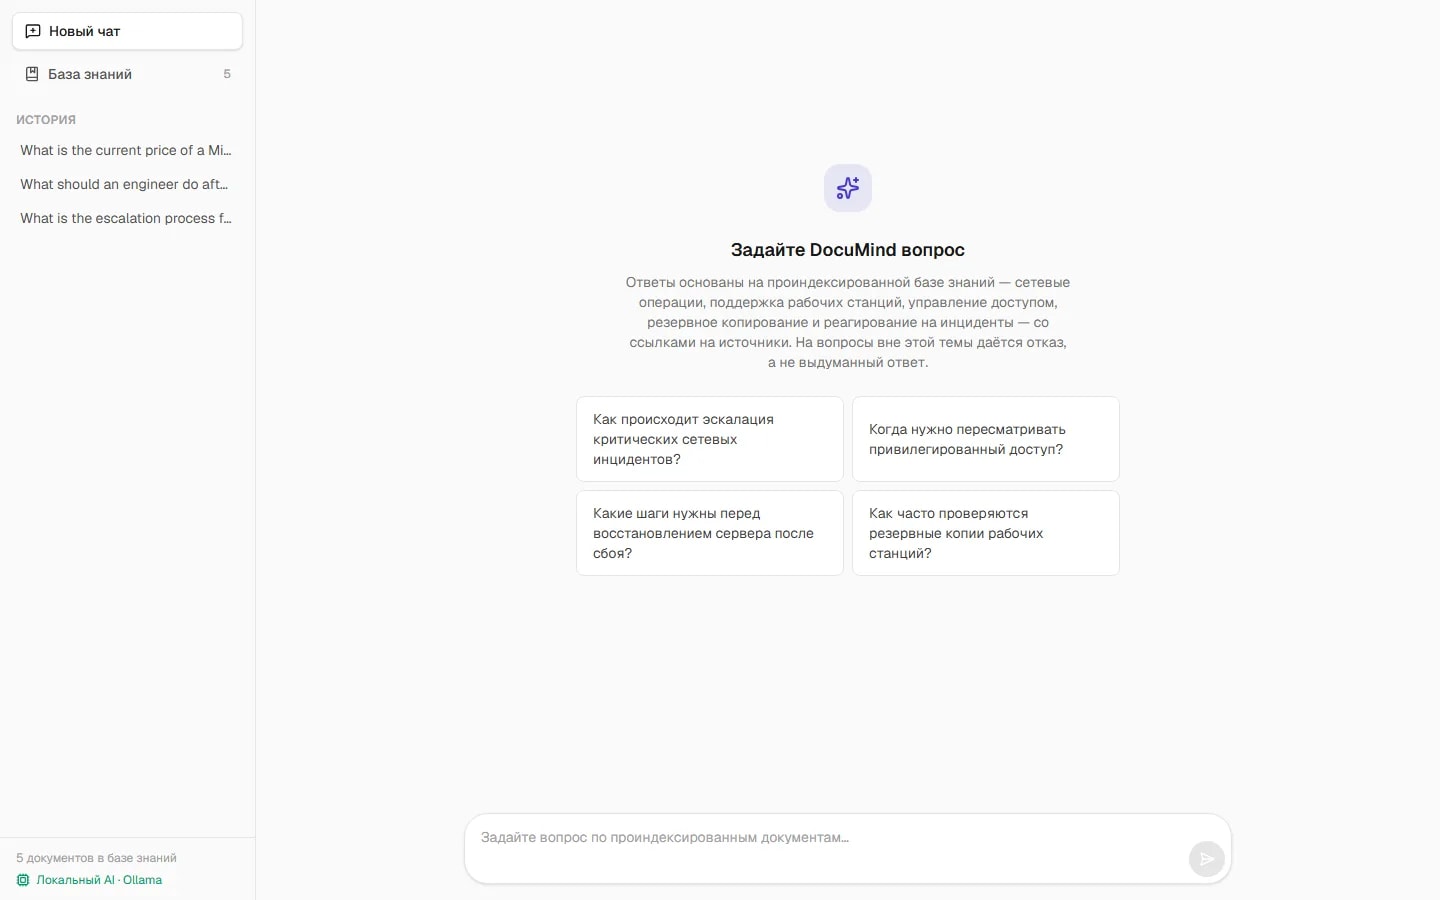
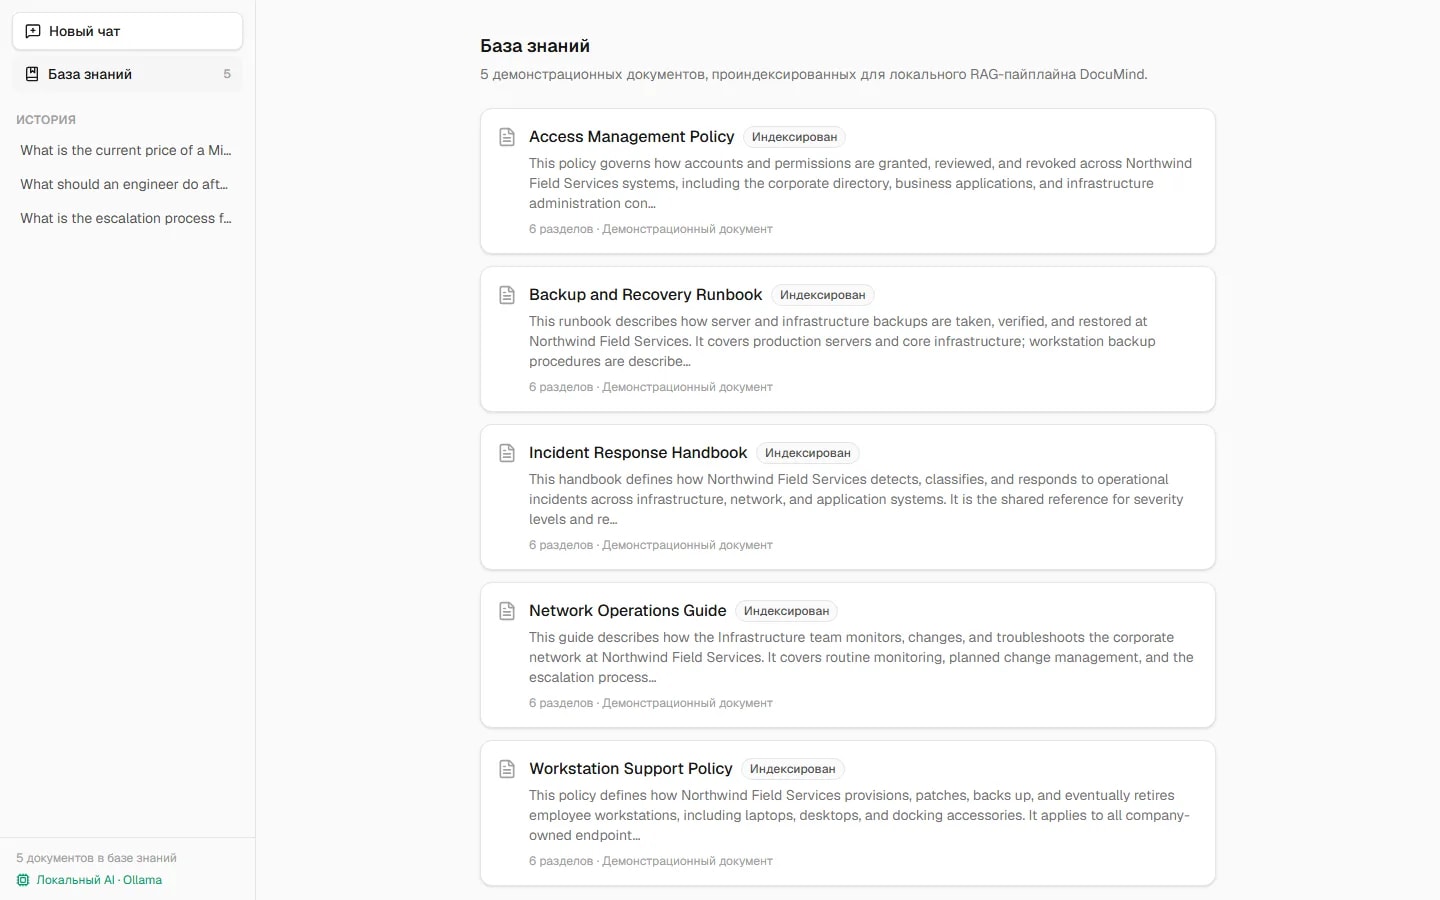
DocuMind — AI-помощник по документации: отвечает только по проиндексированным источникам, показывает их и честно отказывается, если ответа нет в базе.
01 / ЗАДАЧА
Поиск ответа в объёмной технической документации занимает время, а обычный чат с LLM без привязки к документам может дать правдоподобный, но неверный ответ — модель отвечает по своим догадкам, а не по факту.
02 / РЕШЕНИЕ
DocuMind ищет по смыслу (semantic search через pgvector) внутри проиндексированного корпуса документов и строит ответ строго из найденных фрагментов. Если ничего релевантного не найдено, модель вообще не вызывается — отказ происходит на уровне поиска, а не как решение самой модели. Каждая цитата, которую вернула модель, дополнительно сверяется с реально найденными фрагментами: несуществующий источник отбрасывается, а ответ без ни одной подтверждённой цитаты показывается как честный отказ, а не как обоснованный ответ.
03 / КЛЮЧЕВЫЕ ФУНКЦИИ
Только те функции, которые поддерживают основной пользовательский сценарий.
05 / АРХИТЕКТУРА
Документы разбиваются на смысловые фрагменты (по заголовкам, абзацам и предложениям, а не произвольной длиной) и превращаются в embeddings — локально через Ollama (nomic-embed-text) либо через OpenAI, выбор провайдера задаётся одной настройкой. Фрагменты хранятся в PostgreSQL с pgvector и HNSW-индексом. Вопрос пользователя превращается в embedding тем же способом и сопоставляется через cosine similarity в Postgres; если ни один фрагмент не проходит измеренный порог схожести, языковая модель не вызывается вовсе. Если вызывается — генерация опирается на найденные фрагменты и возвращается в структурированном, провалидированном по схеме виде; цитаты модели пересекаются с реально найденными источниками до того, как ответ попадает пользователю.
06 / ПРОВЕРКА
Цифры относятся к зафиксированной проверенной версии проекта.
07 / ОГРАНИЧЕНИЯ
СЛЕДУЮЩИЙ ШАГ
Опишите её в свободной форме — отвечу и предложу, как к ней подступиться.